
Hello, 各位 iT 邦幫忙 的粉絲們大家好~~~
這系列文源自這幾年在團隊裡導入 AI Coding 之後,一路踩雷、修正、再踩雷的真實過程。把這些收斂出來的方法整理成文,也許對正在煩惱同樣問題的你會有些幫助。
就當作是一份邊做邊記的工程筆記吧!
本篇是 當 AI 加入團隊:打造可審查、可驗證、會自我改善的 AI 開發工作流 系列文的 EP14。
團隊累積久了,自然會有一種需求。
「我記得之前好像有人遇過類似的狀況,能不能讓 AI 自己去查?」於是我們加入了一個團隊共享的記憶查詢能力——但特別把它的定位限縮成 recall-only(僅供參考)。
記憶可以幫忙回想,但不能直接變成現在的標準答案。
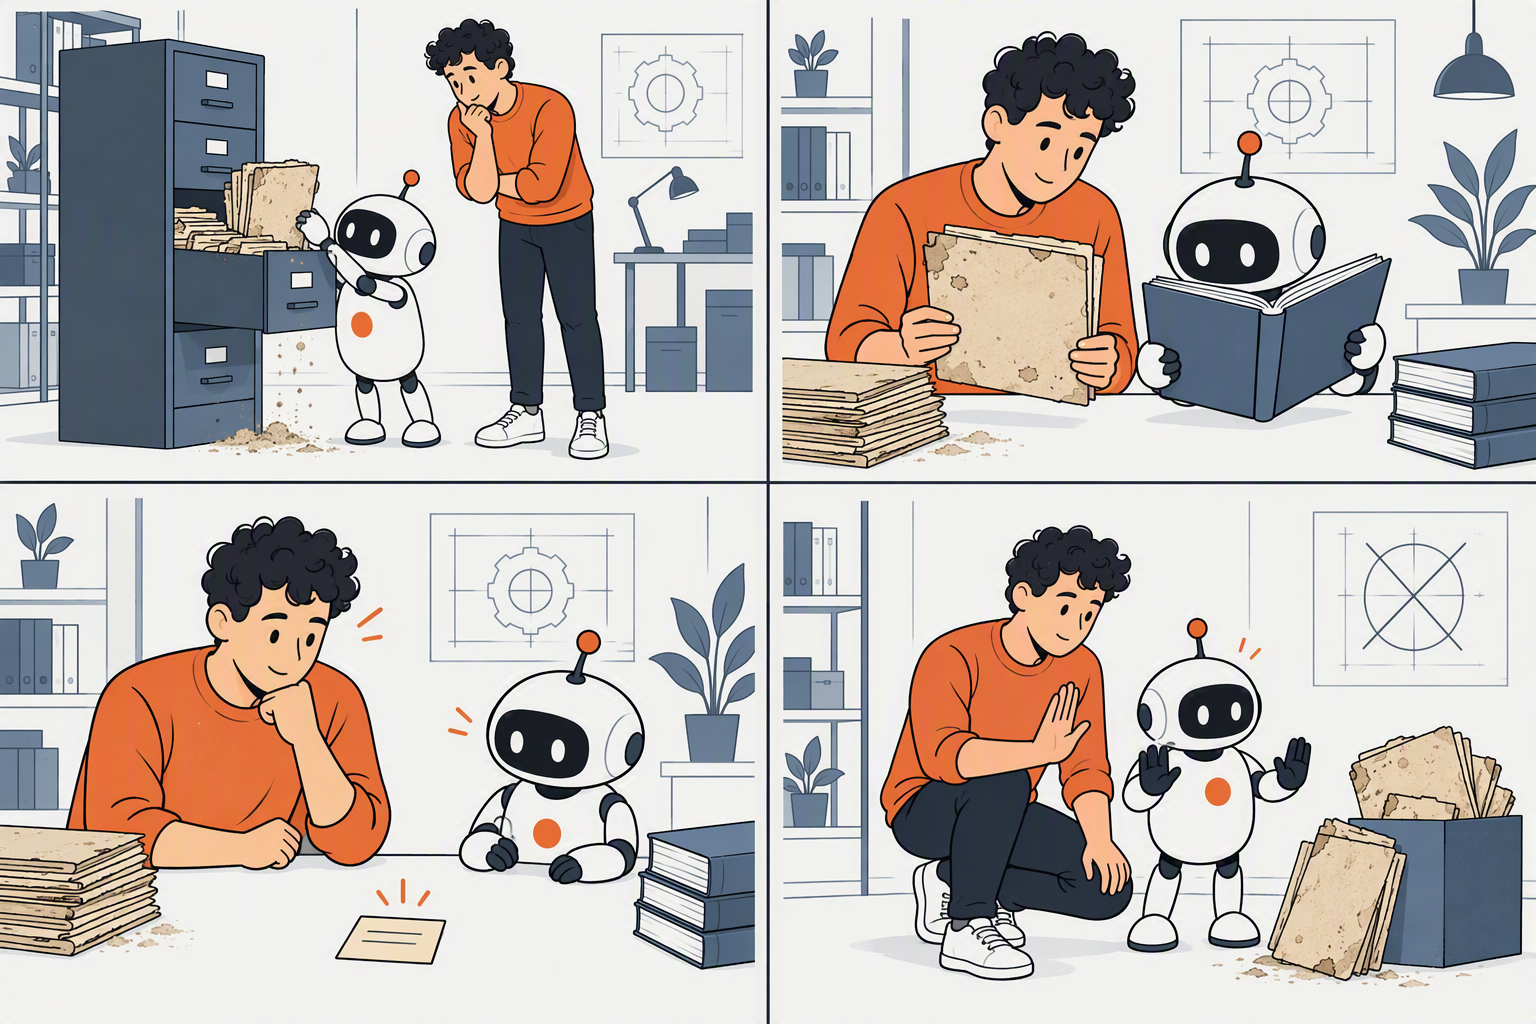
這裡的關鍵限制是:記憶可以提供過去的決策、踩過的雷、或者一段有用的提示,但它不能直接覆寫共用規則。 任何值得長期採用的內容,仍然要走 EP08、EP09 提過的回顧與審查流程,才能真正變成規則。
為什麼要這麼嚴格?因為「記憶」天生帶著雜訊——它可能是某次在特殊環境下才成立的暫時解法,也可能已經被後來的規則修正取代了。
如果讓 AI 把任何查得到的舊紀錄都當成現在的標準答案,很容易出現「用去年的解法,處理今年已經改版的系統」這種尷尬狀況。
所以我們的做法是:查詢時只取前幾筆最相關的結果,並且要求 AI 拿去跟現有規則、現場證據交叉核對,而不是直接照做。
這讓「曾經有人這樣做過」和「團隊現在正式規定這樣做」,保持清楚的界線。
這加起來其實就一句話:記憶可以提供線索,但不能覆寫共用規則;值得長期採用的,仍要走審查。
記憶可以幫忙但不能取代審查,那反過來說:AI 每次到底該讀多少上下文,才不會讀過頭、也不會漏掉重要的東西?
下一篇來聊這個。


 iThome鐵人賽
 看影片追技術